

Jeneratif yapay zeka
Bu madde, Oyunum kavram dizini kapsamında hazırlanmış bir sözlük incelemesidir.
Jeneratif yapay zeka (GenAI), makine öğreniminin metin, görüntü, video, ses ve bilgisayar kodu gibi yeni dijital veri biçimleri üreten alt dalıdır. Bu sistemler eğitim verisindeki örtük örüntüler ve yapıları öğrenerek doğal dil sorgularına yanıt olarak daha önce var olmayan içerikler üretir. Yapay zekanın çıkarım (discriminative) modellerinden farklı olarak, jeneratif modeller veri dağılımını modelleyip buna uygun yeni örnekler örnekler. Son yıllarda büyük dil modellerinin ve görüntü üretim modellerinin gelişmesiyle teknolojinin merkezine yerleşmiştir.
Teorik Temel: Veri Dağılımını Modelleme Sanatı
Jeneratif yapay zekanın felsefi ve matematiksel temeli, gözlemlenen veri kümesinin arka plandaki dağılımını öğrenme arzuya dayanır. Bir model eğitim verisini yalnızca ezberlemek yerine, o veriyi üretmiş olabilecek gizli olasılık dağılımını tahmin etmeye çalışır. Bu bakımdan jeneratif modeller, veri uzayında 'neyin mümkün olduğunu' kodlayan bir fonksiyon inşa eder; ardından bu fonksiyonu kullanarak eğitim setinde hiç karşılaşmadığı yeni noktaları örnekler. Matematiksel olarak düşünürsek, model P(x) biçiminde bir olasılık yoğunluğunu yakalamaya çalışır ve buradan yeni x örnekleri çeker. Bu yaklaşım, sınıflandırıcı modellerin aksine 'bu girdi hangi sınıfa ait' sorusundan ziyade 'benzer bir girdi nasıl üretilir' sorusuna odaklanır.
Bu teorik çerçevede modelin başarısı, eğitim verisinin derinliğini ve çeşidliliğini ne kadar iyi yakaladığına bağlıdır. Model veri dağılımının yalnızca yüzey özelliklerini öğrenirse, ürettiği çıktılar kaba taklitlerle sınırlı kalır; ancak dağılımın özünü kavradığında sürpriz ama tutarlı yeni içerikler üretebilir. İşte jeneratif zekanın yaratıcılık tartışmasının kaynağı buradan gelir: Sistem gerçekten 'yaratıyor' yoksa yalnızca istatistiksel olasılıkları yeniden sentezliyor? Bu sorunun cevabı, modelin öğrendiği örüntülerin soyutluk düzeyiyle doğrudan ilişkilidir. Ne kadar derin ve katmanlı bir temsil inşa ederse, ürettiği içerik o kadar özgün ve bağlama uygun olur.
Mimari Çeşitlilik: Transformerlardan GAN'lara ve Diffusion Modellerine
Jeneratif yapay zekanın gelişimi, ardışık mimari atılımlarla şekillenmiştir. Erken dönemdeki tekrarlayan sinirsel ağlar (RNN) ve uzun-kısa süreli hafıza birimleri (LSTM), dizisel veriler için umut verse de uzun bağımlılıkları yakalamakta yetersiz kalmıştır. Bu açığı kapatmak Transformer mimarisiyle mümkün olmuştur; self-attention mekanizası, dizi içindeki her öğenin diğerleriyle etkileşimini paralel biçimde hesaplayarak dil modellerinde devrim yaratmıştır. GPT serisi ve BERT gibi yapılar bu mimariyi üstün performansla kullanarak jeneratif dil işleme alanında yeni bir çağ açmış, büyük dil modellerinin (LLM) önünü açmıştır.
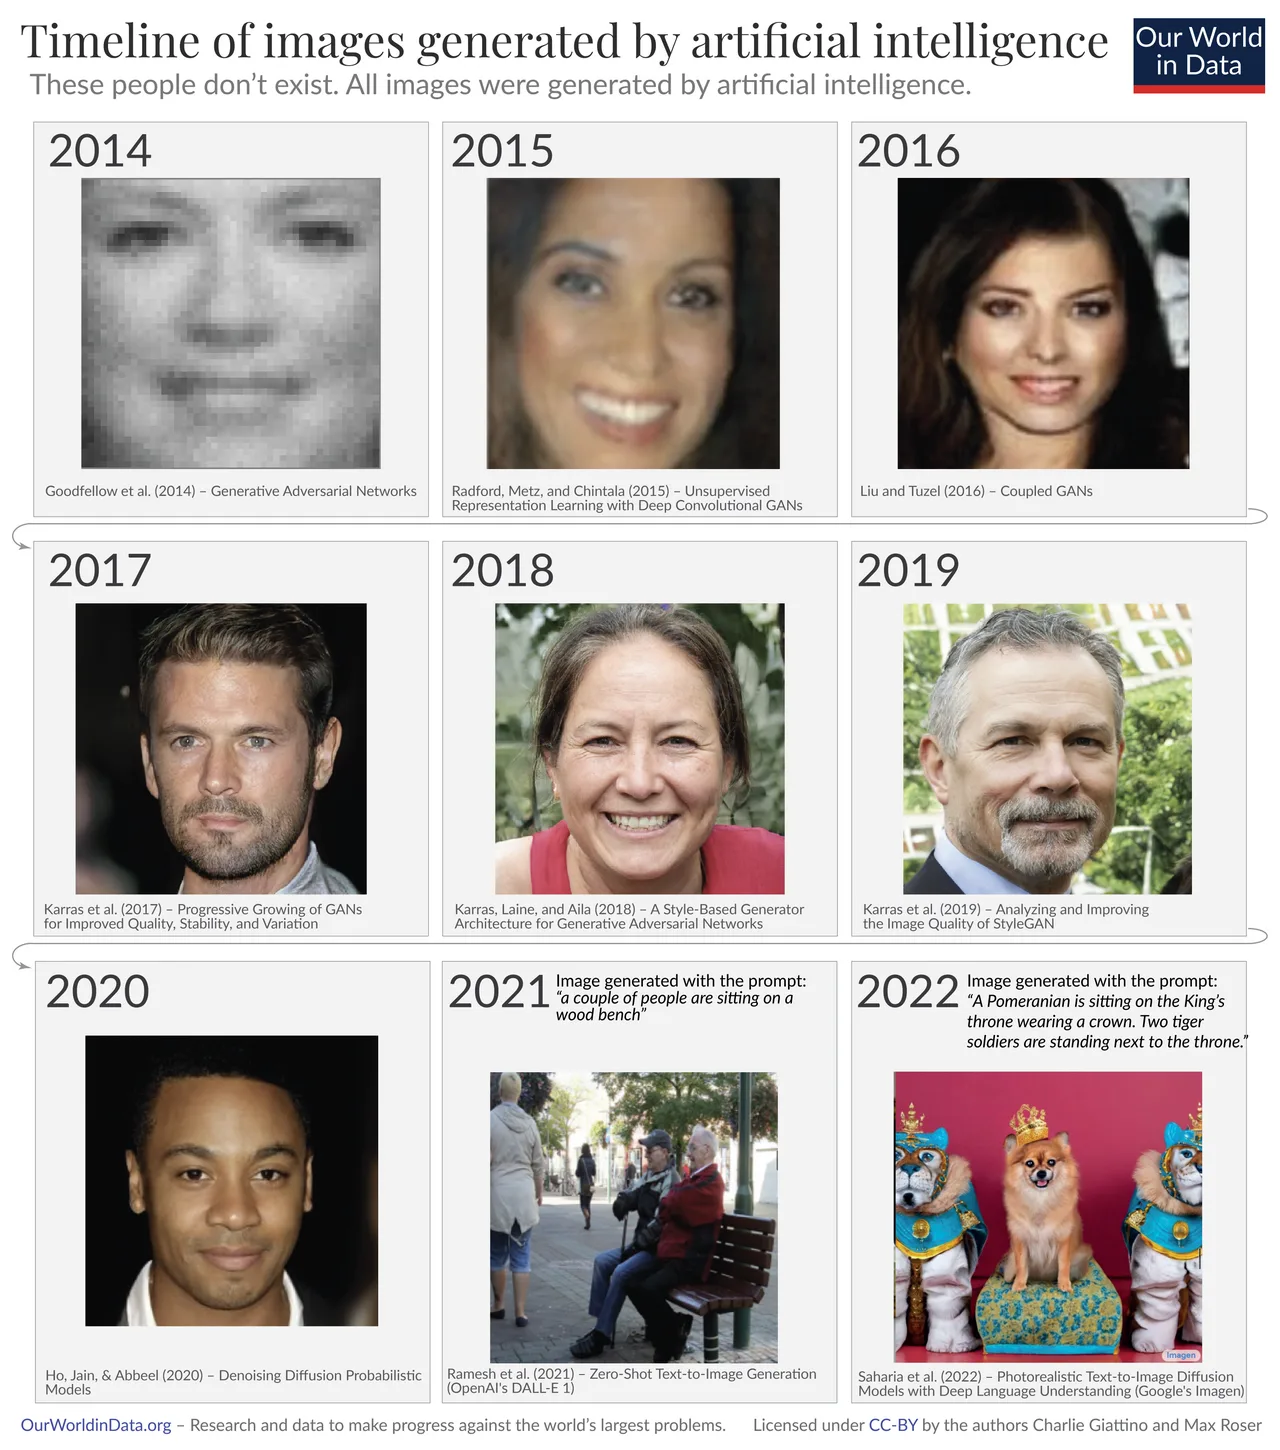
Görüntü üretimi ise iki farklı filozofik yaklaşım etrafında gelişmiştir. Üretici Çevirici Ağlar (GAN'lar), 1990'larda ortaya çıkan ve iki modelin birbirine karşı rekabet etmesiyle çalışan bir çerçevedir: Bir üreteç sahte örnekler üretirken, ayırt edici model bunları gerçek veriden ayırmaya çalışır. Bu sıfır-toplam oyunu, üreteci giderek daha inandırıcı çıktılar üretmeye iterken, eğitim sürecinin kararsızlığı GAN'ların başlıca zorluğu olmuştur. Buna karşılık diffusion modelleri, gürültüden netliğe doğru ilerleyen bir süreçle çalışır: Model, rastgele gürültünün adım adım temizlenerek istenen görüntüye dönüştürülmesini öğrenir. Stable Diffusion ve DALL-E 2 gibi sistemler bu yaklaşımı benimseyerek eğitimdeki kararsızlık sorununu aşmış ve yüksek kaliteli görsel üretimde öne çıkmıştır.
Doğal Dil Sorgularına Tepki: In-Prompt Sürecinin İç Mekanizması
Jeneratif modellerin kullanıcıyla etkileşimi, doğal dil sorguları (prompt) üzerinden gerçekleşir. Bir sorgu model beslendiğinde, sistem bu girdiyi vektör uzayına dönüştürür ve daha önce öğrendiği dağılımı kullanarak muhtemel devamları adım adım üretir. Her adımda model, geçmiş metne dayalı olarak bir sonraki token'in olasılık dağılımını hesaplar; ardından bu dağılımdan bir seçim yapar. Bu süreç 'otomatik regresyon' olarak adlandırılır ve her yeni kelime, önceki kelimelerin oluşturduğu bağlamı sürekli biçimde zenginleştirir. Sonuçta model, sorgunun niyetini istatistiksel olarak yorumlayıp buna uygun bir metin yığını örer.
Bu üretimin kalitesini etkileyen kritik parametreler vardır: sıcaklık (temperature) ve top-p örnekleme gibi ayarlar, modelin rastlantısallık düzeyini belirler. Düşük sıcaklık değerleri daha deterministik ve tahmin edilebilir çıktılar verirken, yüksek değerler daha sürpriz ve çeşitli sonuçlar doğurur. Bu dengelemeler olmadan modeller ya çok tekrarcı ya da bağlamdan kopuk metinler üretebilir. Ayrıca 'önceden işlenmiş' (pre-fill) sorgu ile 'üretilen' çıktının birleşimi, modelin kendi üretimini geri besleyerek tutarlılığı korumasını sağlar; bu mekanizma uzun ve karmaşık yanıtların bütünlüğünü mümkün kılar.
Etik Zorluklar: Telif Hakkı, Halüksinasyon ve Yanlış Bilgi Yayılımı
Jeneratif yapay zekanın yaygınleşmesiyle öne çıkan en ciddi sorunlardan biri halüksinasyondur; model, dilbilgisel açıdan doğru ama gerçeğe uymayan veya uydurma bilgiler üretme eğilimindedir. Bu durum, modelin gerçek bilgiyi öğrenmekten ziyade kelimeler arasındaki istatistiksel benzerlikleri taklit etmesinden kaynaklanır. Model bir olayı 'akıllıcı' biçimde anlatabilir ancak içeriğin doğruluğunu garanti edemez; bu da tıp, hukuk ve bilim gibi güvenilirliğin kritik olduğu alanlarda ciddi riskler yaratır. Bu sorunu azaltmak için modeller doğruluk denetim mekanizmaları ve bilgiye dayalı yanıtlama (RAG) yöntemleriyle desteklenmektedir.
Diğer bir etik mesele, eğitim verisindeki telif hakkı ve taze içerik tartışmasıdır. Modeller, çoğu zaman yaratıcıların açık izni olmadan yayımlanmış metin, görsel veya müziklerle eğitilmiştir. Bu durum, üretilen çıktının orijinal eserlere aşırı benzerliği durumunda hukuki çatışmaları tetiklemiştir. Ayrıca modeller eğitim verisindeki önyargıları öğrenip bunları yeniden üretme eğilimindedir; cinsiyet, ırk ve kültürel önyargılar çıktıların içine sinmektedir. Bu nedenlerle şeffaflık, veri kaynaklarının belgelenmesi ve içerik etiketleme gibi düzenleyici önlemler, teknolojinin sürdürülebilir biçimde benimsenmesi için tartışma konusudur.
❓ Sıkça Sorulan Sorular (SSS)
Jeneratif modeller eğitim verisini ezberleyip ezberlemediğini nasıl ayırt edebiliriz?
Bir modelin yalnızca istatistiksel örüntüleri öğrenip öğrenmediğini anlamak için 'memnuniyet oranı' (memorization score) gibi ölçütler kullanılır. Bu metrik, eğitim verisindeki belirli veri parçalarının modele ne kadar kolayce geri üretildiğini analiz eder; eğer model eğitimdeki ham metinleri birebir tekrar edebiliyorsa bu ezberlemenin bir göstergesi sayılır. Ezberleme ile genelleme arasındaki ince çizgi, modellerin aşırı uyumalması (overfitting) riskini de ortaya koyar. Bu nedenle modern eğitim yöntemlerinde正则leştirme ve veri çeşidliliği gibi tekniklerle ezberleme eğilimi minimize edilmeye çalışılır.
Diffusion modelleri GAN'lardan neden daha az kararsız bir eğitim sunar?
GAN'ların kararsızlığı, üreteç ve ayırt edici model arasındaki rekabetin dengeli sürdürülmesinin zor olmasından kaynaklanır; biri diğerini baskılınca eğitim çöker. Diffusion modelleri ise bu rekabet yerine deterministik bir süreç izler: Rastgele gürültünün adım adım temizlenmesini öğrenir ve her adım net, hesaplanabilir bir hedefe sahiptir. Bu nedenle gradient sinyalleri daha stabildir ve eğitimi denlemek GAN'lara göre daha kolaydır. Sonuç olarak diffusion modelleri yüksek kaliteli çıktılar üretirken eğitim istikrarı açısından avantaj sağlar.


